




Akhir pekan lalu, OpenAI mengumumkan sistem kecerdasan buatan generatif baru yang disebut Sora yang menghasilkan video pendek dari perintah berbasis teks. Meskipun Sora belum tersedia untuk umum, demo berkualitas tinggi yang dipublikasikan sejauh ini telah menarik reaksi gembira dan prihatin.
Video demo yang diterbitkan oleh OpenAI, yang menurut perusahaan dibuat langsung oleh Sora tanpa diedit, menunjukkan keluaran dari tantangan seperti “video close-up foto-realistis dari dua kapal bajak laut yang saling bertarung sambil berlayar dalam cangkir kopi” dan “bersejarah cuplikan dari California. selama demam emas”.
frameborder=”0″ izinkan=”akselerometer; pemutaran otomatis; tulis papan klip; media terenkripsi; giroskop; gambar di dalam gambar; berbagi web” izinkan layar penuh>
Pada pandangan pertama, seringkali sulit untuk mengatakan bahwa mereka dihasilkan oleh AI, karena kualitas video yang tinggi, tekstur, dinamika pemandangan, pergerakan kamera dan tingkat konsistensi yang baik.
CEO OpenAI Sam Altman juga memposting beberapa video di X (sebelumnya Twitter) yang dibuat sebagai tanggapan terhadap tantangan yang disarankan pengguna untuk menunjukkan kemampuan Sora.
https://t.co/rmk9zI0oqO pic.twitter.com/WanFKOzdIw
— Sam Altman (@sama) 15 Februari 2024
Bagaimana cara kerja Sora?
Sora menggabungkan fungsi alat pembuatan teks dan gambar dalam apa yang disebut “model transformator difus”.
Transformers adalah jenis jaringan saraf yang pertama kali diperkenalkan oleh Google pada tahun 2017. Transformers terkenal karena penggunaannya dalam model bahasa besar seperti ChatGPT dan Google Gemini.
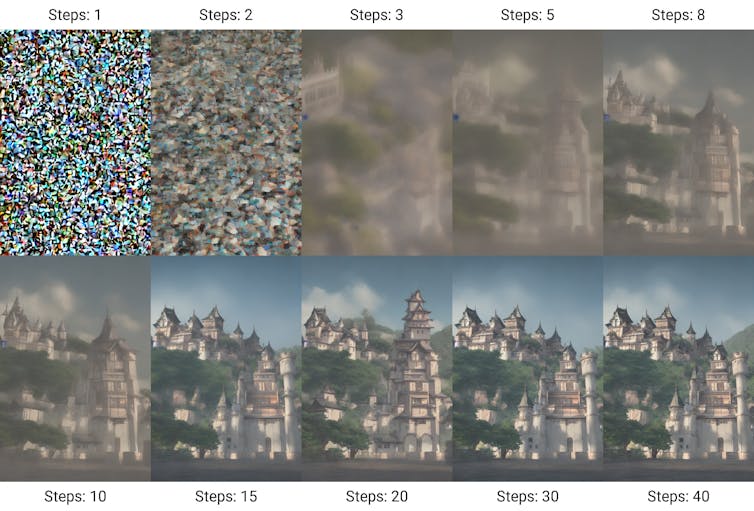
Model difusi, sebaliknya, adalah dasar dari banyak generator gambar AI. Mereka bekerja dengan memulai dengan noise acak dan berlanjut ke gambar “bersih” yang cocok dengan perintah masukan.
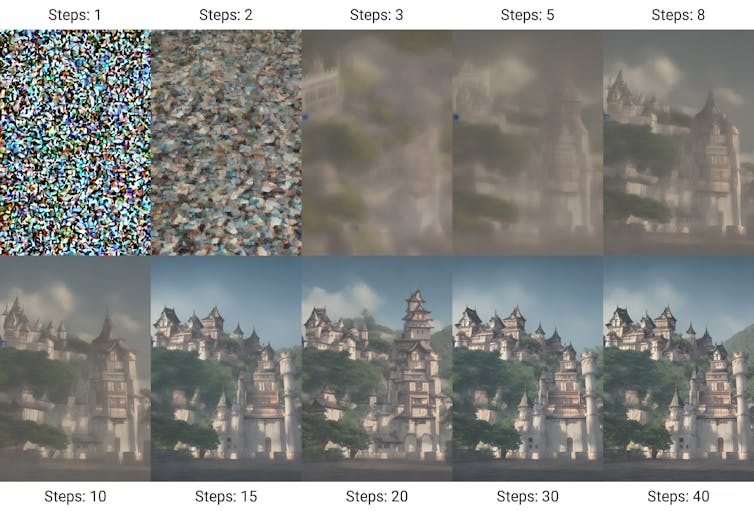 Model difusi (dalam hal ini Difusi Stabil) menghasilkan gambar dari noise dalam banyak iterasi.
(Siaran Stabil/Benlisquare/Wikimedia, CCTV)
Video dapat dibuat dari rangkaian gambar tersebut. Namun, dalam video, koherensi dan konsistensi antar frame sangatlah penting.
Sora menggunakan arsitektur transformator untuk menangani keterkaitan kerangka kerja. Meskipun Transformers awalnya dirancang untuk menemukan pola dalam token yang mewakili teks, Sora malah menggunakan token yang mewakili potongan kecil ruang dan waktu.
Memimpin kelompoknya
Sora bukanlah model teks-ke-video pertama. Model sebelumnya termasuk Meta’s Emu, Runway’s Gen-2, Stability AI’s Stable Video Diffusion, dan yang terbaru adalah Google Lumiere.
Dirilis beberapa minggu lalu, Lumiere diklaim mampu menghasilkan video yang lebih baik dibandingkan pendahulunya. Tapi Sora tampaknya lebih kuat dari Lumiere setidaknya dalam beberapa hal.
Sora dapat menghasilkan video hingga 1920×1080 piksel dan dalam berbagai rasio aspek, sedangkan Lumiere dibatasi hingga 512×512 piksel. Video Lumiere berdurasi sekitar 5 detik, sedangkan Sora membuat video berdurasi hingga 60 detik.
Lumiere tidak bisa merekam video multi-shot sementara Sora bisa. Sora, seperti model lainnya, juga dikatakan mampu melakukan tugas pengeditan video seperti membuat video dari gambar atau video lain, menggabungkan elemen dari video berbeda, dan meregangkan video dalam waktu.
frameborder=”0″ izinkan=”akselerometer; pemutaran otomatis; tulis papan klip; media terenkripsi; giroskop; gambar di dalam gambar; berbagi web” izinkan layar penuh>
Kedua model menghasilkan video yang sangat realistis, tetapi dapat mengalami halusinasi. Video Lumiere bisa lebih mudah dikenali sebagai AI. Video Sora terlihat lebih dinamis dan lebih banyak interaksi antar elemen.
Namun, banyak contoh video yang menunjukkan ketidakkonsistenan setelah diperiksa lebih dekat.
Aplikasi yang menjanjikan
Konten video saat ini diproduksi dengan memfilmkan dunia nyata atau menggunakan efek khusus, yang bisa mahal dan memakan waktu. Jika Sora tersedia dengan harga yang wajar, orang dapat mulai menggunakannya sebagai perangkat lunak pembuatan prototipe untuk memvisualisasikan ide dengan biaya yang jauh lebih rendah.
Berdasarkan apa yang kita ketahui tentang kemampuan Sora, bahkan dapat digunakan untuk membuat video pendek untuk beberapa aplikasi di bidang hiburan, periklanan, dan pendidikan.
Buku putih OpenAI tentang Sora berjudul “Model Pembuatan Video sebagai Simulator Dunia”. Makalah ini mengklaim bahwa versi generator video yang lebih besar seperti Sora dapat menjadi “simulator yang mumpuni dari dunia fisik dan digital serta objek, hewan, dan manusia yang menghuninya.”
“Katedral raksasa itu penuh dengan kucing. Ke mana pun Anda melihat, selalu ada kucing. Seorang pria memasuki katedral dan membungkuk kepada raja kucing raksasa yang duduk di atas takhta.”
Video itu dibuat oleh Sora. pic.twitter.com/bkNqCnckUo
— Bill Peebles (@billpeeb) 17 Februari 2024
Jika benar, versi masa depan mungkin memiliki aplikasi ilmiah untuk eksperimen fisik, kimia, dan bahkan sosial. Misalnya, kita bisa menguji dampak tsunami dengan ukuran berbeda terhadap berbagai jenis infrastruktur – dan terhadap kesehatan fisik dan mental orang-orang di sekitarnya.
Mencapai tingkat simulasi ini sangat menantang, dan beberapa ahli mengatakan bahwa sistem seperti Sora pada dasarnya tidak mampu melakukannya.
Sebuah simulator lengkap perlu menghitung reaksi fisik dan kimia pada tingkat paling detail di alam semesta. Namun, simulasi perkiraan kasar dunia dan pembuatan video realistis untuk mata manusia mungkin dapat dilakukan di tahun-tahun mendatang.
Risiko dan masalah etika
Kekhawatiran utama tentang alat seperti Sora berkisar pada dampak sosial dan etika. Di dunia yang sudah dilanda misinformasi, alat seperti Sora bisa memperburuk keadaan.
Sangat mudah untuk melihat bagaimana kemampuan untuk menghasilkan video realistis dari adegan apa pun yang Anda gambarkan dapat digunakan untuk menyebarkan berita palsu yang meyakinkan atau meragukan rekaman sebenarnya. Hal ini dapat membahayakan upaya kesehatan masyarakat, digunakan untuk mempengaruhi pemilu, atau bahkan membebani sistem peradilan dengan potensi bukti palsu.
Generator video juga dapat memungkinkan ancaman langsung terhadap individu yang ditargetkan melalui deepfake – terutama yang bersifat pornografi. Hal ini dapat berdampak buruk pada kehidupan individu yang terkena dampak dan keluarga mereka.
Selain permasalahan tersebut, terdapat juga permasalahan hak cipta dan kekayaan intelektual. Alat AI generatif memerlukan data dalam jumlah besar untuk dilatih, dan OpenAI tidak mengungkapkan dari mana data pelatihan Sora berasal.
Model bahasa besar dan generator gambar juga dikritik karena alasan ini. Di Amerika Serikat, sekelompok penulis terkenal menggugat OpenAI atas kemungkinan penyalahgunaan materi mereka. Kasus ini menyatakan bahwa model bahasa besar dan perusahaan yang menggunakannya mencuri karya penulis untuk membuat konten baru.
Ini bukan pertama kalinya dalam beberapa waktu terakhir teknologi telah melampaui hukum. Misalnya, pertanyaan tentang kewajiban platform media sosial untuk memoderasi konten telah menimbulkan perdebatan sengit selama beberapa tahun terakhir – sebagian besar berkisar pada Pasal 230 Undang-Undang AS.
Meskipun kekhawatiran ini nyata, berdasarkan pengalaman masa lalu, kami tidak berharap kekhawatiran tersebut menghentikan perkembangan teknologi pembuatan video.
OpenAI mengatakan pihaknya “mengambil beberapa langkah keamanan penting” sebelum merilis Sora ke publik, termasuk bekerja sama dengan para ahli di bidang “disinformasi, konten kebencian, dan bias” serta “menciptakan alat untuk membantu mendeteksi konten yang menyesatkan.”
Vahid Pooryousef, Mahasiswa PhD dalam Interaksi Manusia-Komputer, Monash University dan Lonni Besançon, Asisten Profesor dalam Visualisasi Data, Linköping University
Artikel ini diterbitkan ulang dari The Conversation di bawah lisensi Creative Commons. Baca artikel aslinya.




+ There are no comments
Add yours