





Pada hari Selasa, Nvidia merilis Chat With RTX, chatbot AI gratis yang dipersonalisasi mirip dengan ChatGPT yang dapat berjalan secara lokal di PC dengan kartu grafis Nvidia RTX. Menggunakan LLM bobot terbuka Mistral atau Llama dan dapat mencari file lokal dan menjawab pertanyaan tentangnya.
Obrolan Dengan RTX berfungsi pada PC Windows yang dilengkapi GPU NVIDIA GeForce RTX seri 30 atau 40 dengan VRAM minimal 8 GB. Teknologi ini menggunakan kombinasi retrieval-augmented generation (RAG), perangkat lunak NVIDIA TensorRT-LLM, dan akselerasi RTX untuk mengaktifkan fungsi AI generatif langsung di perangkat pengguna. Pengaturan ini memungkinkan percakapan dengan model AI menggunakan file lokal sebagai kumpulan datanya.
“Pengguna dapat dengan cepat dan mudah menghubungkan file PC lokal sebagai kumpulan data ke model bahasa besar sumber terbuka seperti Mistral atau Llama 2, memungkinkan kueri untuk mendapatkan jawaban yang cepat dan relevan dengan konteks,” tulis Nvidia dalam postingan blog promosi.
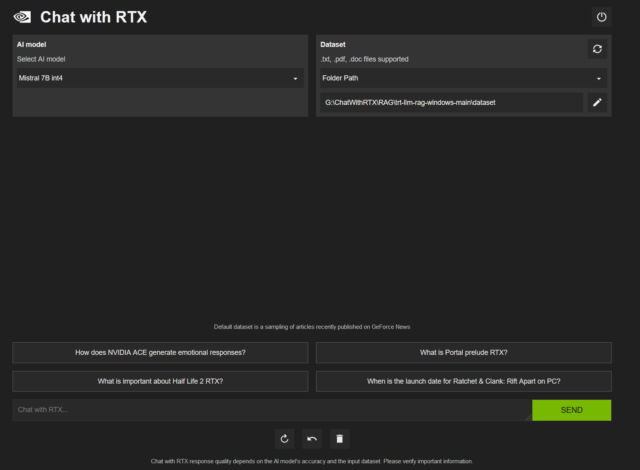 Perbesar / Tangkapan Layar Obrolan Dengan RTX yang berjalan di jendela browser web.
Benj Edwards
Menggunakan obrolan dengan RTX, pengguna dapat membicarakan berbagai topik atau meminta model AI untuk merangkum atau menganalisis data, mirip dengan berinteraksi dengan ChatGPT. Secara khusus, model Mistal-7B memiliki modifikasi bawaan untuk menghindari topik sensitif tertentu (seperti seks dan kekerasan, tentunya), namun pengguna mungkin dapat menggunakan model AI tanpa sensor dan mendiskusikan topik terlarang tanpa paternalisme yang melekat pada model yang disensor. .
Aplikasi ini juga mendukung berbagai format file, termasuk .TXT, .PDF, .DOCX, dan .XML. Pengguna dapat mengarahkan alat untuk menelusuri folder tertentu, yang kemudian akan dipindai oleh Chat With RTX untuk menjawab pertanyaan dengan cepat. Bahkan memungkinkan Anda untuk memasukkan informasi dari video dan daftar putar YouTube, dan menawarkan cara untuk memasukkan konten eksternal ke dalam basis pengetahuan Anda (dalam bentuk penyematan) tanpa memerlukan koneksi internet untuk memproses kueri.
Kasar di bagian tepinya
Kami mengunduh dan meluncurkan Chat With RTX untuk mengujinya. Pengunduhannya sangat besar, sekitar 35 gigabyte, berkat file skala Mistral dan Llama LLM yang disertakan dalam distribusi. (“Bobot” adalah file jaringan saraf aktual yang berisi nilai yang mewakili data yang diperoleh selama proses pelatihan AI.) Saat diinstal, Obrolan Dengan RTX mengunduh lebih banyak file dan berjalan di jendela konsol menggunakan Python dengan antarmuka yang muncul ke atas. di jendela browser web.
Selama pengujian kami pada RTX 3060 dengan VRAM 12 GB, Obrolan Dengan RTX mengalami error. Seperti antarmuka LLM sumber terbuka, Obrolan Dengan RTX adalah kumpulan dependensi berlapis yang mengandalkan Python, CUDA, TensorRT, dan banyak lagi. Nvidia tidak memecahkan kode untuk membuat instalasi menjadi elegan dan tidak rapuh. Ini adalah solusi kasar yang terasa sangat mirip dengan kulit Nvidia pada antarmuka LLM lokal lainnya (seperti GPT4ALL). Meski begitu, perlu dicatat bahwa kemampuan ini resmi datang langsung dari Nvidia.
Di sisi lain (sisi baiknya), kemampuan pemrosesan lokal menekankan privasi pengguna karena data sensitif tidak perlu ditransfer ke layanan cloud (seperti ChatGPT). Penggunaan Mistral 7B tampaknya memiliki kemampuan yang sama dengan GPT-3 pada awal tahun 2022, yang masih luar biasa untuk LLM lokal yang berjalan pada GPU konsumen. Ini belum merupakan pengganti nyata untuk ChatGPT, dan tidak dapat mengungguli GPT-4 Turbo atau Google Gemini Pro/Ultra dalam kekuatan pemrosesan.
Pemilik GPU Nvidia dapat mengunduh Chat With RTX secara gratis di situs Nvidia.






+ There are no comments
Add yours